监控不是装了个插件就可以了,而是要构建一个完整的性能感知系统
网站上线之后,如何能够长久稳定地运行才是最重要的。很多站点的性能问题都是渐进式的——今天慢200毫秒,下个月慢1秒,半年之后用户已经开始流失了,站长却浑然不觉。一个完善的监控系统就相当于站点的“体检报告”,可以使每一个性能指标的微小变动都无所遁形。
前端体验指标:Core Web Vitals
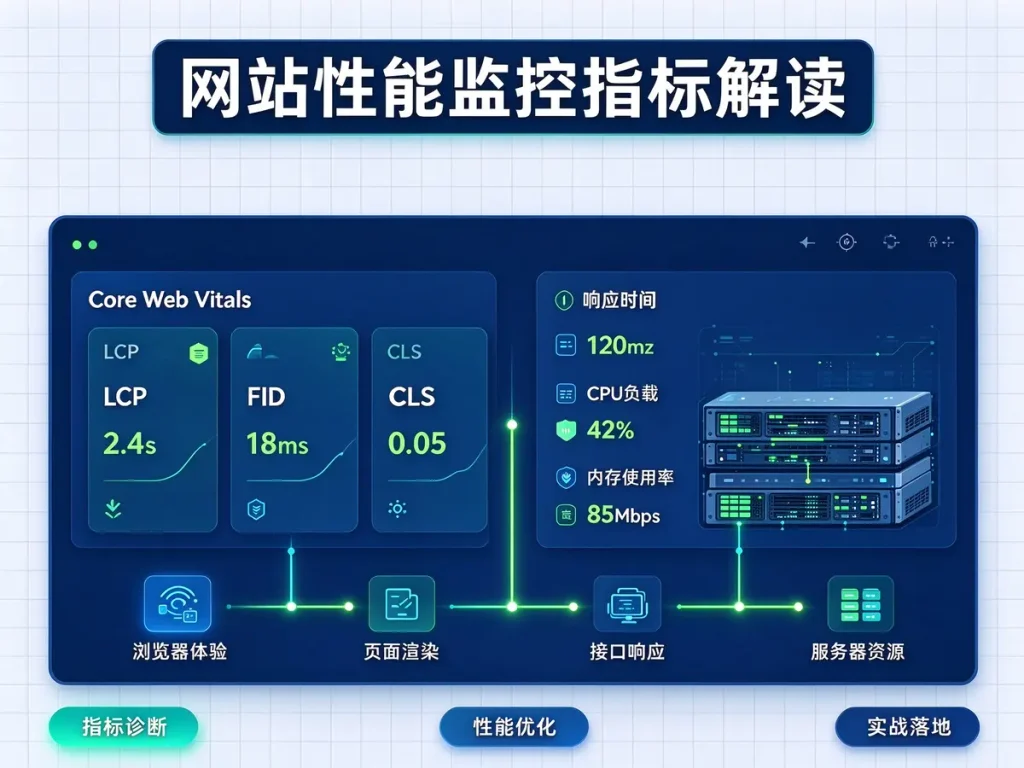
Google在2020年推出了Core Web Vitals(核心网页指标),现在已经成为搜索引擎排名的一个重要因素。三个重要的指标都会影响用户体验以及SEO效果:
LCP(最大内容渲染时间)
定义:页面从开始加载到最大内容元素渲染完成的时间。
及格标准:≤2.5秒算良好,2.5到4.0秒之间算需要提高,超过4.0秒就是很差。
主要原因就是首屏大图没有进行压缩、字体文件导致渲染缓慢以及服务端响应慢。
优化方案:首图使用next-gen格式(WebP/AVIF)并做响应式适配;关键CSS内联、非关键CSS异步加载;服务端启用HTTP/2推送或103 Early Hints预加载关键资源。
INP(交互到下次绘制)
定义: 用户进行交互操作(点击、触摸等)之后,页面出现视觉反馈所花的时间。从2024年3月开始,将FID作为主要考核标准。
及格线:≤200毫秒为良好,200-500毫秒为需要改进,>500毫秒为差。
常见的原因有:主线程因为一个长长的任务而被阻塞(单个任务的执行时间大于50毫秒),大量的DOM操作集中在一起执行。
优化方案:把长任务分成多个部分,用scheduler.yield()或者setTimeout来分割;将耗时大的逻辑放在Web Worker里执行;减少第三方脚本的加载时间,非重要脚本在页面加载完成之后再进行加载。
CLS
即页面生命周期中所有的意外布局偏移的总和。
及格线:≤0.1为良好,0.1~0.25为有待改进,>0.25为差。
出现的原因:图片没有设置好宽高比,广告位动态插入,异步加载的字体造成FOUT/FOIT。
优化方案:所有的媒体元素都声明了width和height属性或者使用aspect-ratio CSS;给动态内容留出空间容器;使用font-display: optional或者提前加载重要的字体。
检测工具推荐:PageSpeed Insights(综合评分+实测数据)、WebPageTest(多地域、多设备测试)、Lighthouse CI(集成到部署流程中自动检测)、Chrome DevTools 的 Performance 面板(详细分析渲染过程)。
服务器资源监控指标
CPU使用率
如果CPU一直高于80%,那么CPU就成为了瓶颈。要区分user态和system态的比例:user态高一般是因为应用代码计算量大(比如大量的循环、正则匹配),而system态高则表明有较多的系统调用(比如大量的短连接、大量的文件操作)。使用top -H命令查看线程级别的占用情况,配合perf top来找出热点函数。
内存监控要点
不要只看free命令的free列,那是个误导性的指标——Linux会尽量利用空闲内存做文件缓存(buffer/cache),这些内存在应用需要时会被回收。真正要关注的是available列和swap使用情况。swap si/so不为零的话就说明内存已经非常紧张了,应该马上检查内存泄漏问题。
磁盘IO
使用iostat -x 1来查看一些重要的数值:
%iowait: CPU等待IO的时间占整个时间的百分比,如果超过20%,那么磁盘就是瓶颈
等待时间:单次IO请求的平均等待时间,机械硬盘超过20ms、SSD超过5ms都算慢
%util:磁盘利用率,接近100%意味着IO饱和
解决的方法有:将热点数据迁移到SSD上;调整MySQL的innodb_flush_log_at_trx_commit参数(在可以接受一定数据丢失风险的情况下);提高脏页刷新的比例来降低突发的IO压力。
网络监控
每秒入站/出站的流量、TCP连接数以及重传率。重传率超过1%就说明网络质量存在问题,可能是带宽饱和、网卡驱动bug或者机房链路不稳定。TCP TIME_WAIT堆积会导致端口耗尽,调优net.ipv4.tcp_tw_reuse和tcp_fin_timeout参数。
数据库性能监控
慢查询日志就是性能问题的金矿
开启MySQL的慢查询日志功能(slow_query_log=ON,long_query_time可以设置为1秒左右),使用pt-query-digest工具进行解析,按照执行时间总和进行排序,先优化排在前面的一些SQL语句——因为它们对系统的整体性能影响最大。
要特别重视的数据库主要指标
- QPS/TPS是指每秒查询数/事务数,根据业务量来判断是否合理
- 连接数:Threads_connected和max_connections的比率大于80%的时候需要进行扩容或者优化连接池
- 缓冲池命中率 = Innodb_buffer_pool_read_requests / (reads + read_requests),小于99%说明内存不足或者工作集过大
- 锁等待:Innodb_row_lock_waits突然升高意味着存在热门行的竞争,多见于库存扣减、计数器等情况
- 临时表:Created_tmp_disk_tables / Created_tmp_tables 比率很大,表明SQL语句中GROUP BY或者ORDER BY造成了磁盘临时表,应该优化索引
实战案例
某电商站点的首页加载时间从800ms逐渐增加到3秒,监控数据显示数据库QPS正常、CPU正常,但是Innodb_row_lock_waits每分钟从个位数增长到上千次。排查之后发现是商品详情页的“浏览量+1”操作在高并发情况下对单行记录造成了大量的锁竞争。优化方案:把实时计数换成Redis累加,定时批量写回数据库,首页耗时马上下降到了600ms以内。
建立告警机制
选择适当的工具组合
| 层级 | 推荐方案 | 核心能力 |
|---|---|---|
| 基础设施 | Node Exporter + Prometheus | CPU/内存/磁盘/网络时序数据 |
| 可视化 | Grafana | 自定义Dashboard与多数据源 |
| 告警通知 | Alertmanager / 企业微信/钉钉 | 分级告警+抑制+静默 |
| 前端监控 | Sentry / 百度统计 | JS错误捕获+性能数据采集 |
| 日志分析 | ELK / Loki | 全链路日志检索与关联分析 |
告警阈值设置的原则
Warning级别的触发条件为:CPU使用率持续超过70%的时间达到5分钟以上。
Critical级别:需要马上处理,比如5xx错误率大于5%或者磁盘剩余空间小于10%。
告警风暴防护很重要。一次宕机如果触发了几百条告警的话,那么真正重要的信息就会被淹没掉。合理的设置group_wait(首次告警等待)和group_interval(同组告警合并间隔),让一条故障只产生一条汇总通知。
性能优化的持续闭环
监控的目的不是“看数据”,而是用数据来指导行动。建议建立一个闭环流程:
采集、分析、优化、验证、回归
每周一进行性能巡检:查看上周Core Web Vitals的趋势、慢查询TOP10以及服务器资源的峰值。每季度进行一次全面的性能调优工作,对TOP3的性能瓶颈制定优化方案,上线之后通过对比数据来检验效果,保证优化不会带来新的问题。
一些通用的优化建议如下:
- CDN可以缓存静态资源,使用长缓存和文件名哈希的方式
- 启用Brotli压缩(比Gzip再节省15%-20%的空间)
- 数据库读写分离、热点数据加 Redis 缓存层
- PHP启用OPcache之后,在PHP 8.0以上版本中JIT默认为打开状态
- 定期删除过期的日志文件和临时文件,避免磁盘空间被占用
- Nginx启用gzip_static,使压缩在部署的时候完成而不是在请求的时候进行实时压缩
网站性能优化是没有终点的,而是一个不断的过程。好的监控体系可以在问题影响到用户之前就发现它,使每一次优化都有数据支持、有量化结果。把性能监控作为日常运维的标配,不等到故障发生后亡羊补牢,站点才能真正做到又快又稳。