2001年敏捷宣言发布后,开发端的迭代速度被大幅释放,但运维端并未同步改变。开发团队以周为单位交付功能,运维团队仍以月为单位执行变更管控。两者之间的交接变成了瓶颈——功能“写完了”却卡在部署环节,敏捷的收益在交付给用户之前就被消耗掉了。
这个矛盾在2007—2008年间被反复触及。比利时独立咨询师Patrick Debois在参与一个政府数据中心迁移项目时,需要频繁往返于已经实践敏捷的Dev团队和仍在传统运维模式中“救火”的Ops团队之间。他直观地感受到,开发端的敏捷没有延伸到运维端,整个交付链路仍然是断的。
时至今日国内大部分企业的交付能力还非常有限,每月甚至每两个月部署一次,每次部署开发祈祷代码不会出错,运维祈祷服务器不抽风,但这样的局面本可以避免,这就是今天要介绍的DevOps。
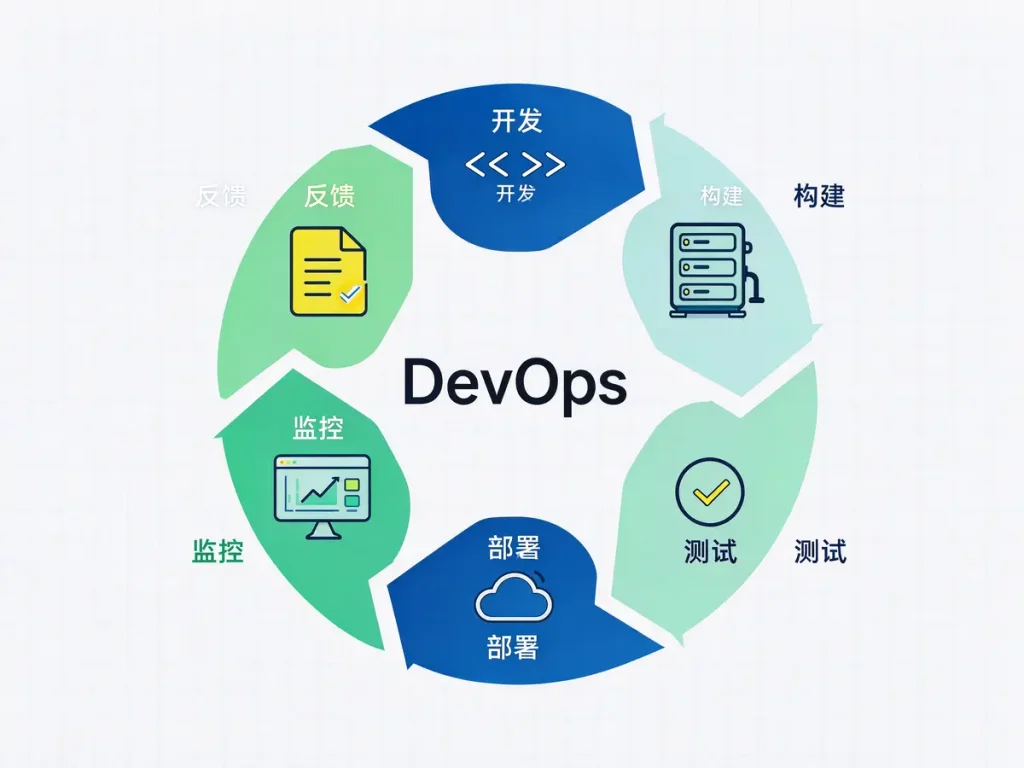
DevOps是一套让软件从“写完代码”到“用户能用”之间距离更短、更安全的协作方式, 也就是开发到交付的完整环。开发不再只对功能负责、把上线甩给运维,运维也不再只是守在门口做最后一道检查。双方共同为软件在生产环境中的表现负责。
一、DevOps出现之前,交付是怎么被挡住的
要理解DevOps为什么存在,先看它要解决什么问题。
传统的软件交付链条是一条分段接力:开发写完代码,本地跑通,交给测试;测试过了,交给运维上线。每一段交接都意味着一次信息损耗和责任转移。开发说“我本地能跑”,运维说“你本地又不是生产环境”。部署失败的时候,没有人真正为“上线之后能不能稳定运行”负全责,因为开发的目标是“功能实现”,运维的目标是“系统别出事”——目标本身是割裂的。
这种割裂在小项目上尚可忍受,因为变更少、影响面窄,人工盯一盯能兜住。但项目一旦变大——微服务变多、部署环境变复杂、发布频率变高——这堵墙的代价就会以指数级放大。一次上线涉及十几个服务、几十个配置项,靠人工协调和口头确认,不出问题才是偶然。
Amazon早年做过一个内部测量,发现代码从签入到真正进入生产环境平均需要16天,而其中真正花在编写、构建和部署上的时间不到一天,剩下的大量时间消耗在等待和协调上。这不是某个人不努力,而是协作方式本身在制造延迟。DevOps要拆的,就是这堵墙。
二、DevOps的价值
DevOps的价值不需要靠理念来证明,已经有一批公司用可量化的结果把它说清楚了。
Netflix是讨论DevOps时绕不开的案例,但重点不是“它用了什么工具”,而是它用交付方式的改变支撑了什么样的业务。 通过在微服务架构上深度实践自动化交付,Netflix达到了每天超过1000次生产部署,同时为全球超过3亿用户维持99.99%的可用性,每周支撑超过10亿小时的流媒体播放。部署工具将发布周期压缩到两分钟以内,而金丝雀部署策略把发布相关的事故率削减了90%。每天部署上千次而用户毫无感知——这在传统交付模式下是难以想象的,因为它要求每一次变更都足够小、足够可观测、出问题能立刻回滚。
Amazon的案例则展示了DevOps对“速度”的直接改造。 在推行持续交付的试点团队中,代码从签入到生产的总时间被缩短了90%,从平均16天降到了以小时计的水平。到今天,Amazon每年在生产环境中的部署次数超过1.5亿次。这个数字本身说明了一件事:当部署不再是“事件”而变成“常态”时,团队对变更的心理负担和操作风险都会发生结构性改变。
这些结果指向同一个结论:DevOps不是在“让工程师更忙”,而是在让交付节奏和系统韧性同时变好。 高绩效团队的生产部署频率可以比低绩效团队高出数百倍,同时变更失败率反而更低——速度快和稳定性好,在这里不是取舍关系,而是同一套工程能力的两个侧面。
三、为什么中大型项目离不开DevOps
大公司做DevOps,不是因为钱多,而是因为项目规模本身会把传统交付模式的脆弱性放大到不可接受的程度。
第一,变更的爆炸半径。 一个单体应用时代的小改动,影响范围是可控的。但当系统拆成几十个微服务、部署在多个环境和可用区之后,一次看似简单的配置变更可能在毫无预警的情况下影响整条业务链路。没有自动化的验证、发布和回滚机制,每一次上线都相当于在没有任何护栏的情况下走钢丝。
第二,环境不一致带来的隐性成本。 大项目通常涉及开发、测试、预发、生产多套环境,依赖的服务和中间件数量多。开发本地能跑、测试环境能跑、生产环境起不来——这类问题在小团队里可能一周遇到一次,在大项目里可能每天发生。Docker解决的核心问题正是这个:它把代码、运行时、系统库和配置打包进一个镜像,让同一个镜像在任何装有容器引擎的机器上都以相同方式启动,从根上消掉“在我机器上能跑”的扯皮。但Docker只解决了“打包和运行”,一旦容器数量从个位数变成几十上百个,谁来决定哪个容器跑在哪台机器上、挂了之后谁来拉起、流量怎么分配?这就是Kubernetes(K8s)要解决的问题:它把“人工管理容器”变成“系统持续维持期望状态”,自动完成部署、扩缩、故障替换和滚动升级。Docker管“一个容器怎么跑”,K8s管“一群容器怎么协同活下去” ——两者加在一起,才让中大型项目在规模扩张时,运维复杂度不至于线性甚至指数级上升。
第三,人对系统的认知负担。 大项目的交付链路长、参与角色多,如果没有标准化的流程和自动化的反馈,每一次发布都高度依赖某几个“知道所有细节的人”。一旦这些人不在,发布就卡住。DevOps用流水线和自动化把关键知识固化到系统里,让交付不再依赖个人记忆。
四、中小企业不用DevOps,可能是一个昂贵的误判
“我们团队就十几个人,搞什么CI/CD”——这是中小企业管理者最常见的反应。但数据给出的答案恰恰相反。
根据中国信通院2025年发布的《中国DevOps现状调查报告》,100人以下研发团队在引入DevOps实践后,平均交付周期从14天缩短到4.5天,部署频率提升3.2倍,线上故障平均恢复时间从4小时降至40分钟,运维人力成本平均降低35%–45%。对于预算和人力都紧张的中小企业来说,这不是“锦上添花”,而是直接作用于生存能力的改善。
中小企业的DevOps不需要从Kubernetes集群和服务网格开始。很多几十人的团队,用免费的GitHub Actions或GitLab CI配合规范的Git分支策略,就能把交付效率做到相当顺畅的水平。关键不在于工具的数量,而在于三件事:把重复劳动自动化、让变更可以被验证、让故障可以被快速发现和回滚。一个50人左右的团队,仅仅通过规范分支策略和强制代码评审,代码冲突率就能下降60%,线上回滚次数从每月5次降到1次以下。这些动作不需要大预算,但需要对“交付方式本身”认真对待。
规模小的时候不建立交付纪律,规模变大时付出的代价会高得多。 十几个人时靠沟通能兜住的问题,到三五十人时会变成系统性的混乱;而等到混乱出现再去补流程,成本远高于在早期把基础习惯建起来。
五、选软件外包时,DevOps能力是一个被低估的信号
如果你正在评估外包团队,DevOps实践水平是一个比“会不会用某个框架”更值得关注的指标。一个具备DevOps能力的团队,通常意味着:交付节奏可预期,不会出现“说好两周上线、拖到两个月”的失控;上线风险可控,出了问题有回滚机制而不是通宵手工排查;环境一致性有保障,不会出现“测试都好好的、一上线就炸”的反复折腾。
你可以直接问对方几个问题:你们的发布流程是什么样的?有没有自动化的测试和部署流水线?线上出问题之后,平均恢复时间大概是多少? 一个真正实践DevOps的团队,回答这些问题时会有具体的流程和数字;而一个只是“听说过DevOps”的团队,往往只能给出模糊的承诺。
DevOps的起点不是工具,而是一个认知:软件的价值只有在生产环境中稳定运行时才算真正兑现,而交付方式本身决定了这个兑现过程是可控的还是脆弱的。 大项目离不开它,是因为规模会把脆弱性放大到无法忽视;中小企业需要它,是因为在资源有限的阶段,效率的每一点提升和故障的每一次减少,都直接作用于竞争力。它不是一套需要“配齐”才能启动的东西——从把重复的手工步骤自动化开始,就已经在路上了。