
恶意爬虫会消耗带宽和数据库连接,提高错误率,在日志中往往和正常的访问混在一起。识别的前提是日志字段要充分利用:来源地址、UA、Referer、状态码、响应字节以及请求时间戳,六项组合起来可以勾勒出行为轮廓,单独看其中一项容易误判。
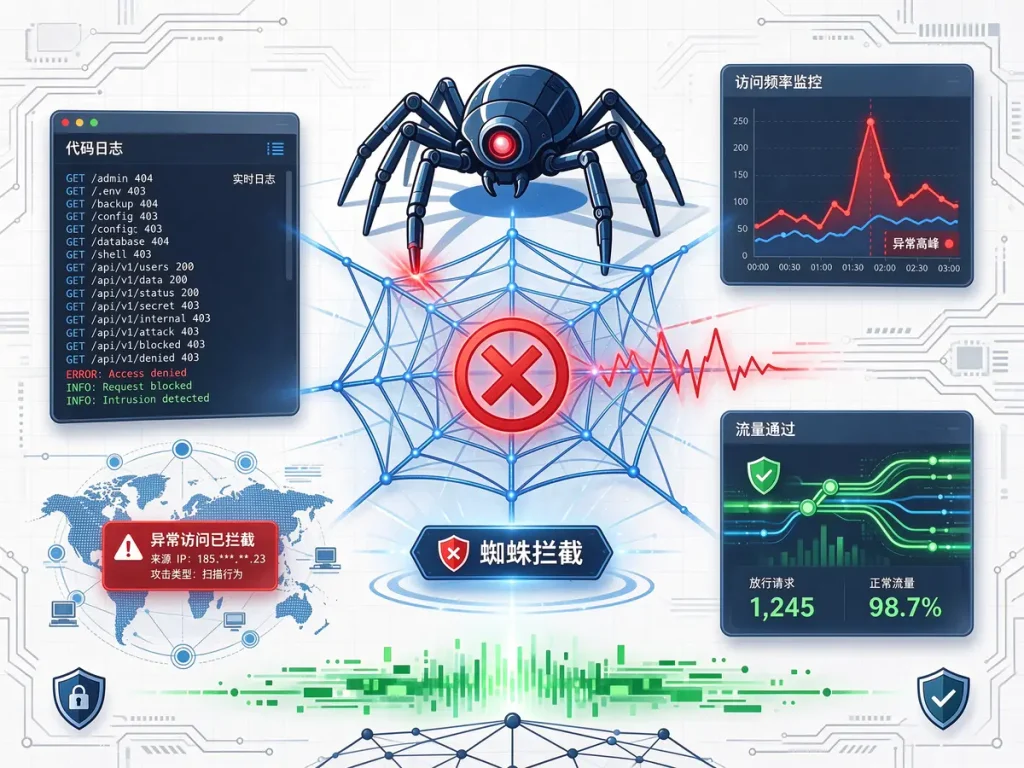
行为特征就是判定依据。固定间隔的高频请求、只抓取列表页不加载静态资源、Referer 一直为空、404 探测比例异常、短时间内遍历大量分页参数等都是典型的表现。UA 伪装也很普遍,声称主流浏览器却在头部字段顺序、协议版本上露出破绽,可以和已知的搜索引擎地址段进行双向核对。
统计的方法不需要很复杂。按小时聚合来源地址的请求量和前十访问路径,结合状态码分布进行排序,异常源一般出现在前面。确认之后按照梯度处理:先限速、再验证、最后封禁,并且更新 robots 和防火墙规则。
日志分析的价值在于持续性,按月进行复盘比一次性清洗更能抑制爬虫的反弹。