
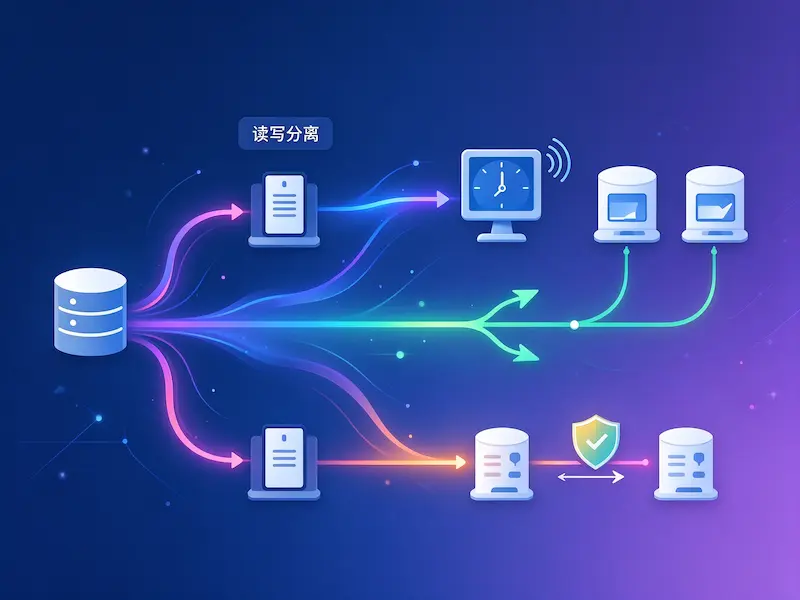
在高并发的情况下,读请求的数量通常是写请求的几倍。读写分离将查询压力分散到多个副本上,如果配置不当的话就会造成数据不一致。
部署之前要先进行主从复制。确定复制模式和半同步设置,副本数量根据读压力来安排,跨机房部署时要考虑到网络延迟对复制的影响。
路由规则决定了实际的收益。只把可以接受延迟的查询指向从库,涉及到下单、支付、权限校验等读操作的请求则保留在主库;同一个请求中的读写操作保持在一个连接上,防止写入之后马上读取得到的是旧的数据。
延迟要监控。以秒为单位设置告警阈值,超过阈值之后会自动把读流量切回到主库,恢复之后再放行。当库发生故障的时候,可以迅速摘除,避免请求一直超时。
分离只是一种方法,最后还是要考虑单表的数据量和索引的质量,否则即使有再多的副本也无法减轻压力。